一首歌怎么生成一支有剧情的 MV?AI 分镜、对口型与参考图驱动实录
能做到什么程度:给一首歌和一段剧情大纲,系统会先听歌拿到节拍、段落和逐句歌词时间,再按节拍拆出逐个时间窗的分镜,用参考图生成画面,唱词段对口型,最后在歌曲指定秒点拼成一支竖屏剧情 MV。 这次做的 59 秒高光段,就是用一首约 3 分半的原创歌,走完这条链路做出来的。
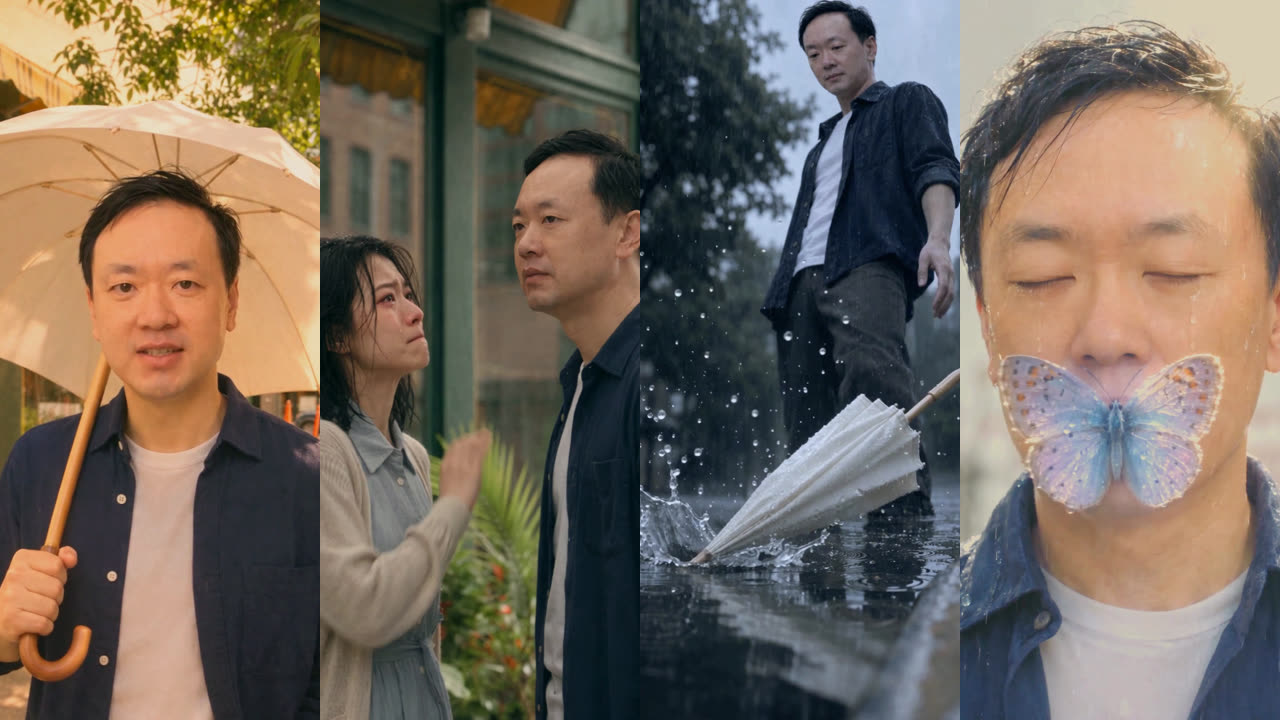
想直接做一支:打开「我的 MV」,新建一部作品
这支片子的输入只有两样:一首歌和一段剧情大纲
做一支剧情 MV,用户只需准备歌和故事,歌词和分镜表由系统先出初稿。
这次的输入是:
- 歌:一首约 3 分半的原创歌曲,手里没有现成歌词文本。
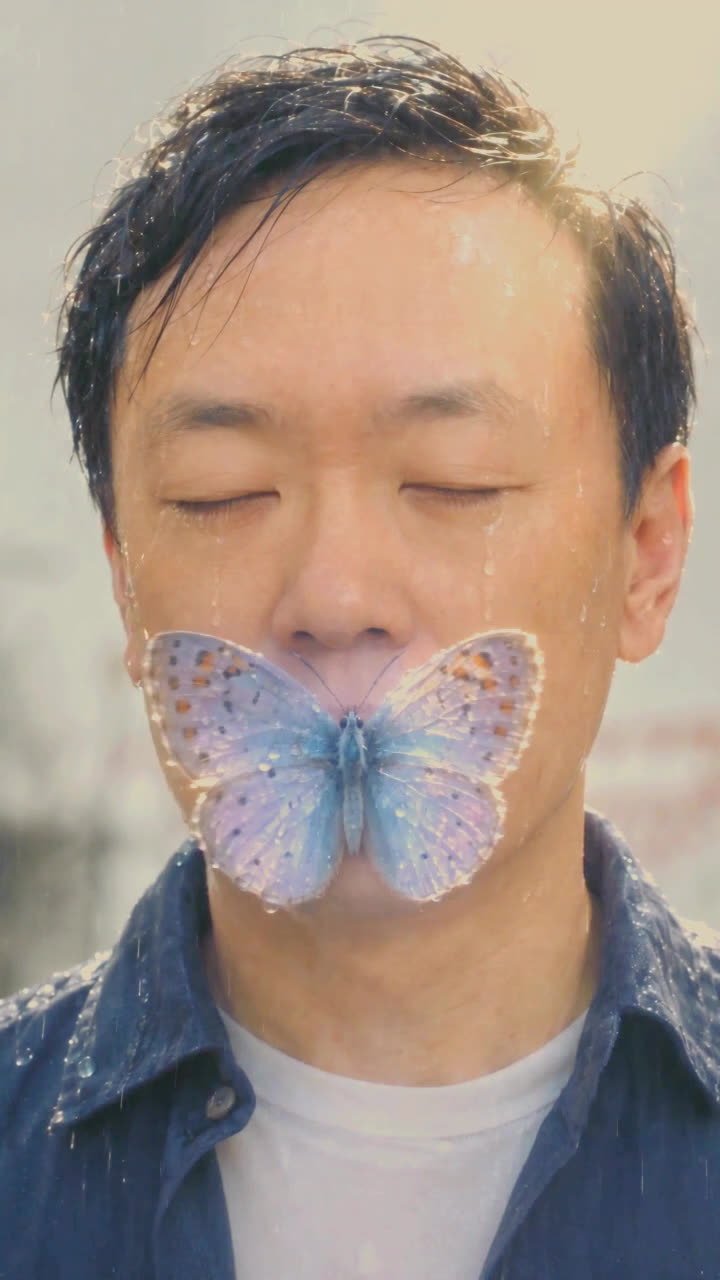
- 剧情大纲:男主撑伞等待 → 女主跑来,两人对话时天色转阴 → 一记耳光用慢动作表现,同时开始下雨 → 雨水和泪水交织 → 雨后转亮,一只蝴蝶飞来停在唇前,画面定格。
大纲里藏着一条天气弧线:晴 → 阴 → 雨 → 雨后转亮,它决定了每个镜头的光线怎么写。
从一首歌到成片,一共 6 步
整条链路可以拆成 6 个有先后的步骤,每一步的产物都是下一步的输入。
- 听歌:系统分析整首歌,得到节拍、段落结构和逐句歌词的时间点。没有歌词文本也能听出来,用户可以手动校对每一句的文字。
- 选高光段:只取有歌词的高光段做成片。这支取的是歌曲第 18.2–77.5 秒,约 59 秒,正好适合竖屏短视频。
- 拆分镜:创作顾问把剧情大纲按节拍拆成一个个时间窗,每个窗口写清表情、动作、光线和氛围,也就是「秒锁」提示词。唱词段安排对口型,无词吟唱段用剧情画面填满。
- 备参考图:每个镜头配好实拍场景底图、人物定妆与身份参考、站位与运镜参考(下一节细说)。
- 分段生成并拼接:画面分两大段生成,每段约 30 秒,各约 6–7 分钟出片;两段在歌曲指定的秒点帧精确拼接。
- 混音收尾:主音轨始终是原歌,镜头自带的环境声压低垫底;结尾只淡出音乐,画面保持亮度定格,不做黑场。
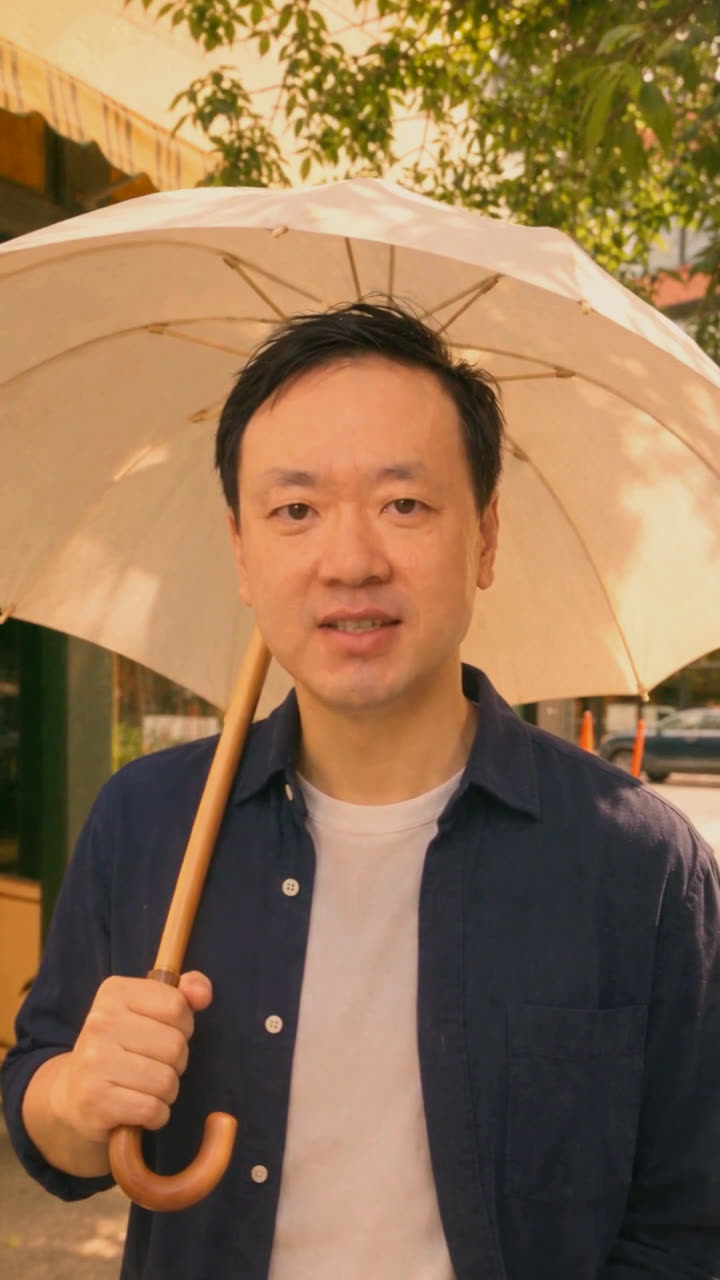
分镜按节拍切,而不是按句子平均切
MV 的分镜要跟着音乐走:镜头切换落在节拍上,情绪转折落在段落交界处,观众才会觉得「画面在跟着歌动」。
所以分镜表不是把 59 秒平均切开,而是以节拍和段落为骨架,把每个剧情动作挂到具体秒数上。比如「天色转阴」放在两人开始对话的那一段,「耳光 + 开始下雨」落在情绪最重的那一拍,并用慢动作拉长。
每个时间窗的秒锁提示词写四件事:表情(期待、委屈、沉默)、动作(撑伞、跑来、抬手、伞落地)、光线(暖阳 → 冷灰 → 雨后转亮)、氛围(街道湿度、雨势、环境声轻重)。
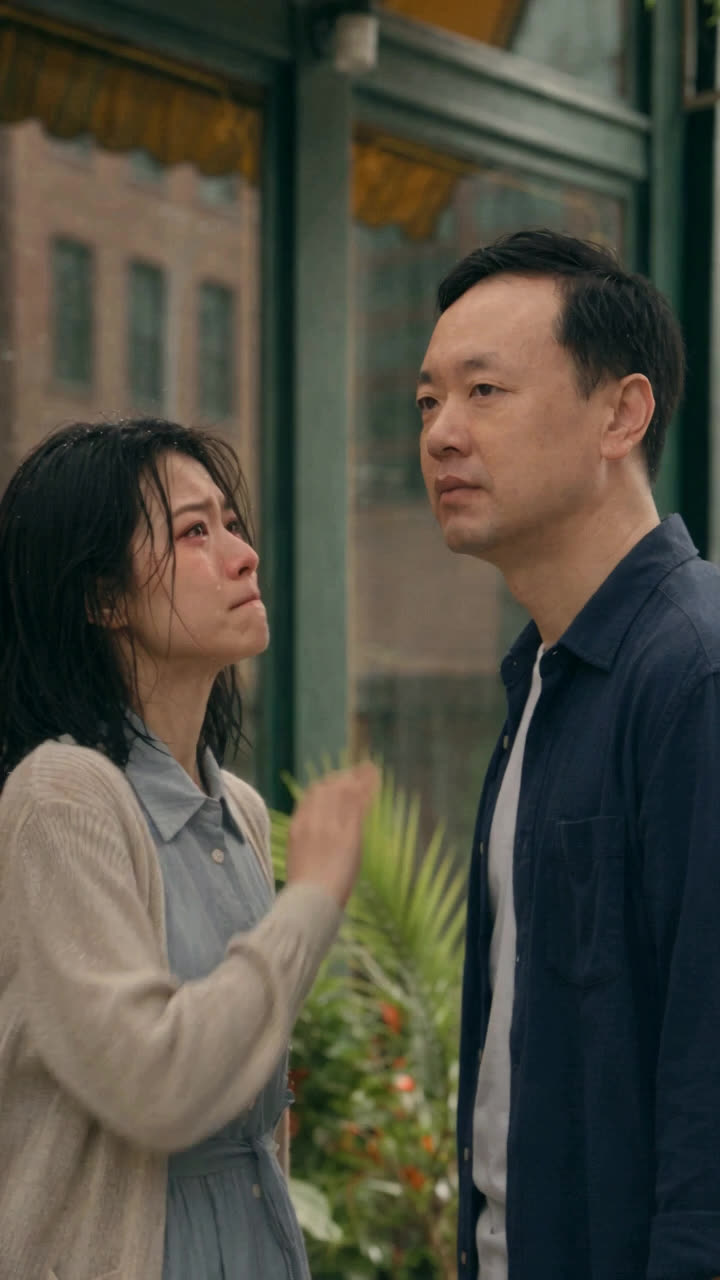
为什么每个镜头都用参考图驱动,而不是纯文字抽卡
纯文字生成每次都像重新抽卡,人物长相、街道、伞的颜色都可能变,十几个镜头很难连成同一个故事。参考图驱动是先钉住「这个人、这条街、这个站位」,文字只描述这一秒发生什么。
每个镜头都带 3 类参考:
- 实拍场景底图:同一地点用同一张母版底图,只改天气和光线。晴天和阴天的店门口是同一张图变出来的,所以门框、遮阳棚、花盆都在原位。
- 人物定妆与身份参考:锁住脸、发型和服装,跨镜头不换人。
- 站位与运镜参考:谁站左谁站右、镜头推还是拉,用图说比用字说可靠。
代价是前期多准备几张图,换来的是不用反复重抽;这些图在总成本里只占很小一部分。
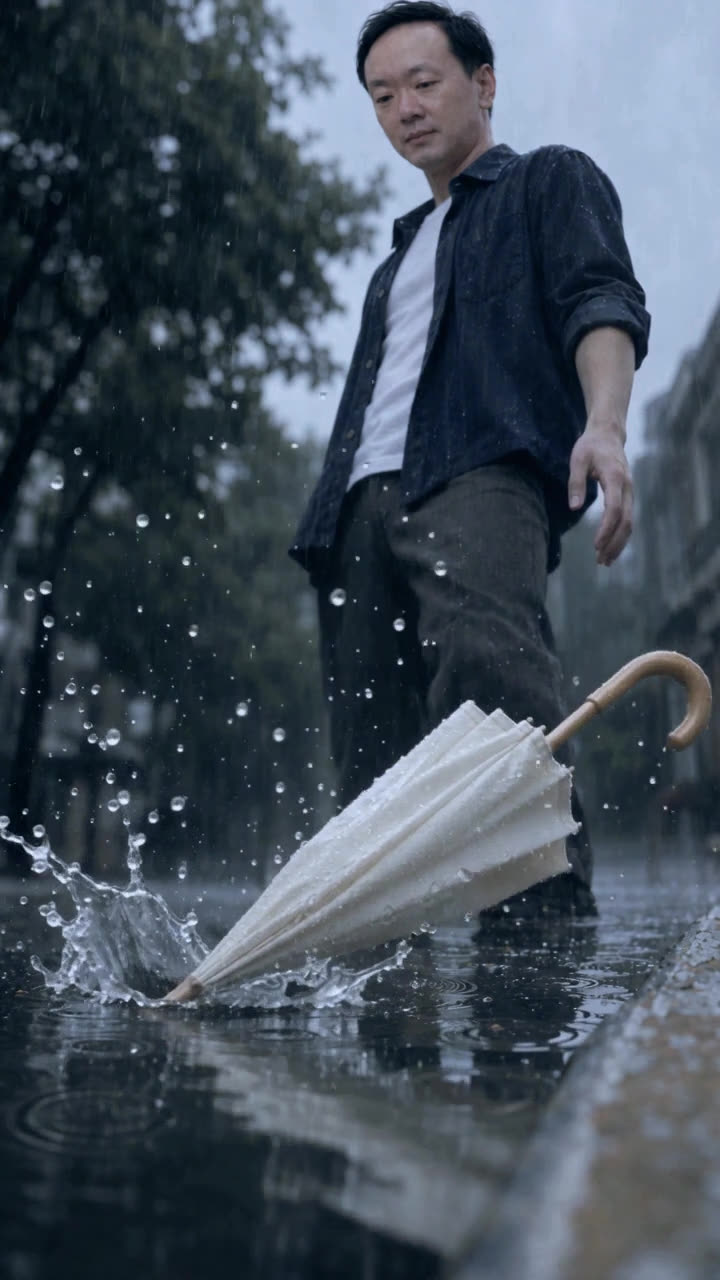
踩过的坑:参考图说了算,提示词拗不过它
这支片子踩了 2 个坑,结论都一样:当参考图和提示词冲突时,画面会跟参考图走。
坑一:伞的状态。 有一个镜头的参考图里伞是撑开的,提示词写了「伞收拢落地」,生成出来伞还是撑着。改法是换一张伞已收拢的参考图。经验:参考图里每样东西的状态都必须和这一秒的剧情一致,不能指望文字去改。
坑二:场景穿帮。 同一个店门口,有一个镜头换了另一张底图,生成出来就像换了一条街,前后镜头接不上。改法是同一地点全部锁回同一张母版底图,只在提示词里改天气和光线。经验:一个地点只能有一张底图。
成片之后还能做的 4 件事
成片后还有 4 个可选的收尾工具:
- AI 调色建议:听着歌看片,按段落给出分段调色方案,让晴、阴、雨、雨后的色调过渡更顺。
- 转场溶解:在段与段之间加溶解转场,让拼接处更柔和。
- 局部修改:哪几秒坏了只重做那几秒,不用整段重来,省时间也省钱。
- 2K / 4K 超分:定稿后对整条成片升清晰度,适合大屏播放或二次剪辑。
花了多久、花了多少
时间:两大段画面各约 6–7 分钟出片;前期校对歌词、改分镜的时间取决于改几轮。
成本:整支 59 秒高光段在「几十美元量级」,其中视频生成占绝大部分,场景图与分镜编排只占很小一部分。返工时用局部修改只重做出问题的那几秒,不用整段重新生成。
完整版 3 分半的整首 MV、以及调色前后的对比,这次没有放出,下期补上。
适合谁,怎么开始
适合手里有歌、想要一支带剧情的竖屏 MV 的人:独立音乐人、给自己的歌做短视频宣传的创作者、想给朋友的歌拍一支故事片的人。
开始只需要 3 步:
- 打开 我的 MV,输入歌名,新建一部作品(新建只建立作品,不会生成歌曲、图片或视频);
- 上传歌曲,等听歌结果出来后校对歌词,选一段 30–60 秒的高光;
- 写一段剧情大纲,让创作顾问拆分镜,补齐场景、人物和站位参考后再生成。
常见问题
一首歌能自动生成一支 MV 吗?
可以。上传歌曲后,系统会先听歌,得到节拍、段落结构和逐句歌词时间,再根据你给的剧情大纲拆成按节拍对齐的分镜,逐段生成画面并拼接成片,主音轨始终用原歌。
没有歌词文本,AI 能对口型吗?
能。听歌这一步会识别出逐句歌词和每一句的时间点,没有现成歌词文本也可以。识别结果可以手动校对,校对后的歌词时间会用在唱词段的对口型镜头上。
AI 生成 MV 的分镜是怎么来的?
创作顾问会把你的剧情大纲按歌曲节拍拆成一个个时间窗,每个时间窗写清表情、动作、光线和氛围。唱词段安排对口型,无词吟唱段用剧情画面填充,你可以在生成前逐条修改。
为什么 AI MV 里的人物和场景能前后一致?
因为每个镜头都用参考图驱动:同一地点用同一张场景底图,只改天气和光线;人物用定妆和身份参考锁住长相;站位和运镜也有参考图。
生成一支约 1 分钟的剧情 MV 要多久、多少钱?
本文这支 59 秒高光段分两段生成,每段约 30 秒,各约 6–7 分钟出片。成本在几十美元量级,其中视频生成占绝大部分,场景图与分镜编排只占很小一部分。
成片里有几秒不满意,需要整支重做吗?
不需要。用「局部修改」只重做出问题的那几秒,其余部分保持不变。成片后还可以做 AI 调色建议、转场溶解和 2K / 4K 超分。
提示词写了动作,生成出来却不对,是什么原因?
最常见的原因是参考图和提示词冲突,画面会跟参考图走。例如参考图里伞是撑开的,提示词写「伞收拢落地」也没用,需要换一张伞已收拢的参考图。